ターンベース対決(Turn-based Duel)
ターン制戦闘の核心:行動権と裁定
これは何か
あなたが1手、相手が1手——先にゴールへ辿り着く競争だ。三目並べ、五目並べ、チェスはすべてこの上に成り立っている。
どう遊ぶか
自分のターンでは盤面が凍り、いくらでも考えられる。指せば状況は一転し、相手は即座に応じる——すべての手が問いかける。「相手は次に何をする?」
なぜ学ぶか
対立構造の最も古く、最もクリーンなモデルだ——戦略の深さがどこから来るかを学ぶなら、ターン権と裁定から始めるのが一番だ。
ターンベースの決闘は、対立を離散的で説明可能な決断点に分解する。ターン権は双方が交互に意図を表明することを保証し、合法性チェックはルールの境界を鮮明に保ち、裁定はすべての対局を閉じる。難しいのはルールではなく、対戦相手の知性の勾配と結末の完全性だ。AI の難易度階段はそのまま学習曲線であり、引き分け分岐の欠落は対局が永遠に終わらないことを意味する。プレイヤーが「負けても納得できる」のは、すべての結果が特定の一手に遡れるからだ。
このメカニクスが重要な理由
プレイヤーにとって
ターンベースの決闘は、最も古い知的競争心を満たす。反射神経への言い訳は通用しない——結果はすべて自分の頭の中にあった。負けはフェアに感じられ、勝ちは報われたと感じられる。
エコシステムにとって
ターン制の対立は、競争的社交の原初形態だ。ルールがそのまま社交プロトコルであり、盤面はネットワーク不要の対面接続である。ボードゲームからカードバトラーまで、対戦プレイの生態の基盤であり続け——AI 対戦相手設計の最古の試験場でもある。
転用できる技術
ターンベースの決闘を学べば、離散決断点の設計が身につく——ターン権、合法性、裁定の閉包。タクティクス、デッキビルダー、さらには非同期のソーシャル対決にまで直接伸ばせる骨格だ。
学習目標
- 入門:ターンのステートマシン(ターン開始 → 行動 → 交代 → 裁定)を理解し、デモで合法手と勝利判定を再現できる
- 中級:完全な合法性チェックと裁定契約(引き分け/盤面満杯の閉包を含む)を書け、ミニマックス AI を繋げられる
- 上級:AI の難易度階段と行動回数ルール(コンボ/クールダウン)を設計し、対局時間分布と先手勝率でバランスを検証できる
コアパターン
② 今すぐプレイ可能なデモ
ターンベース対決(Turn-based Duel) Demo
ゲームを読み込み中…
ルールのヒント
例:先手が駒を置く → 後手が駒を置く → 先手が続ける。どちらかが N 個連結するか、盤面が埋まるまで。
ラボガイド:デモを実験として扱う
AI 階段実験
操作:「AI 強さ(0=ランダム、1=ブロック、2=必勝探索)」の各レベルで1局ずつ通しで対戦する
観察:レベル 0 は合法性のサンドボックスだ(どんな手もルールを教えてくれる)。レベル 1 のブロックは防御の優先順位を教える。レベル 2 はすべての手の長期的な代償を曝け出す。AI 階段はそのまま学習曲線だ——固定難易度の AI は初心者にもベテランにも嫌われる
必勝帰属の観察
操作:レベル 2 の AI を相手に、わざと悪手を指す(例:開いた三を無視する)
観察:探索 AI は即座にそれを罰する——敗因は特定の一手に遡れる。これはターンベースプレイにおける「説明可能な結果」の極致だ。失敗は運ではなく決断に帰属するから、プレイヤーは次に何を学ぶべきかを正確に知っている
引き分け閉包の観察
操作:レベル 1 の AI を相手に、盤面が埋まるまで双方が保守的にブロックし続ける
観察:盤面満杯で連結なしは引き分けだ。裁定は勝/負/引き分けをカバーしなければならない——引き分け分岐を欠けば、対局は永遠に閉じない。最小ルールセットで最も省略されがちなルールがこれだ
③ 行動システムの分解
3.1 解決する課題
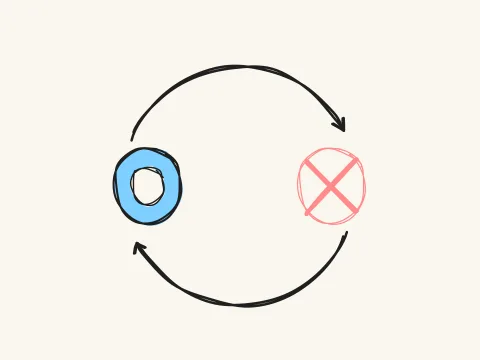
- ターン交代とフェーズマシンで、両者の行動権を明確かつ制御可能に保つ。
- 合法性チェックで、ルールの境界を解釈可能な拒否フィードバックに変える。
- 明確な勝/負/引き分けの裁定で、すべての対局に確定的な結論を与える。
- 1ターン1行動に制限することでペースが安定し、過剰なコンボで即終了するのを防ぐ。複数行動を許せば、1ターンに複数カードを出せて戦略の深さは増すが、対局時間は伸びうる。
- 連結数 N の選択は重要なトレードオフだ。大きすぎると連結を探す時間が長くなりペースが落ち、小さすぎると連結が簡単でゲームが加速する。実験では 15×15 の盤面で N=5 が最もバランスが良い。
- カード制のターンシステムでは、1回の行動で複数カードを出せる(コンボ)方が複雑に見えるが、組み合わせでより高い価値を生み出せるため、実際にはゲームを弱めるのではなく深める。
3.2 最小ルールセット
- 行動権:各ターンは現在のプレイヤーで始まる。1回の行動の後、操作は即座に相手に移る。行動中のプレイヤーは1ターンに1回だけ行動でき、合法性チェックを通過して初めて完了とみなされる。ターン数は1から始まり、現在のプレイヤーを記録する。
- 合法性:配置は盤面内で空いている場所に限る。カード行動では十分なコストと1枚以上の手札が必要。特殊スキルではクールダウンとリソースを満たすこと。非合法な行動は理由付きのエラーコード "InvalidMove" を返す。
- 裁定:どちらかのプレイヤーが同一シンボルを連続 N 個(横、縦、斜め)並べたら、そのプレイヤーの勝ち。盤面に空きがなく連結もなければ引き分け。どちらでもなければターンを続行する。裁定チェックは各合法行動の直後に実行される。
3.3 システムループ(任意)
行動 → 合法性チェック → 盤面更新 → 勝/引き分け判定 → 未決ならプレイヤー交代 → 次のターンへ
設計ノート
AI の強さは難易度ツマミではなく、教育の経路だ。ランダム AI は合法性のサンドボックス、ブロック AI は防御の優先順位を教え、詰み探索 AI は長期的な帰結を曝け出す。3つを並べれば、プレイヤーは今必要な先生を自分で選ぶ。
引き分けは第一級の裁定だ。勝者なしの盤面満杯は明示的に閉じなければ、対局は永遠に終わらない——最小ルールセットで最も省略されがちな項目は、まさにこれだ。
行動制限はリズムと深さの取引だ。1ターン1行動はテンポを軽快に保つが深さに天井を設ける。コンボを許せば戦略空間は爆発するが対局時間は膨らむ——制限は怠慢ではなく、決闘に形を与えるものだ。
④ よくある組み合わせとバリエーション
ターン + グリッド
盤面配置と隣接が行動空間になる(例:五目並べ、オセロ、三目並べ)
ターン + 数値
体力/コストなどの数値勾配がカード制のターン戦闘を支える
ターン + AI
シングルプレイでは AI が相手を操作し、評価関数が難易度の天井を決める
⑤ 発展的な設計とアルゴリズム(折りたたみ)クリックで展開
設計上の注意
- 合法性チェックの欠落は、プレイヤーにルールの抜け穴をバグと(あるいはバグをルールと)誤認させる。
- 調整できない AI 難易度は、初心者にもベテランにも嫌われる。
- 引き分け条件の省略は、対局を決着不能にする(盤面満杯/長期戦は明示的に処理しなければならない)。
- 寛大すぎる裁定ルールは連結を容易にしすぎて、戦略の深さを剥奪する。
アルゴリズムの例
- 勝敗判定:N 連走査、比較ロジック、引き分けルール。
- AI:アルファベータ枝刈り付きミニマックスと盤面評価関数。
⑥ 関連事例記事
Tic Tac Toe Showdown: Turn-Based Line-Matching Game
Tic Tac Toe Showdown teardown: alternating placement, line detection and a minimax AI on a configurable 3x3 grid, with a playable embedded demo.
Same Rules, New Feel: A 3D Makeover for Solved Tic-Tac-Toe
Tic-tac-toe is a solved game — optimal play always ends in a draw. See how 3D rotation, sound and confetti rebuild the feel without changing a single rule.